Le 30 juin, Anthropic lance Claude Sonnet 5. Cette annonce devait susciter la joie des développeurs. Elle provoque une vague de colère.
En lisant leur blog, un détail m’interpelle. Anthropic affirme que Sonnet 5 réduit l’écart avec Opus 4.8 pour un coût bien plus bas. Je me dis que l’entreprise cible enfin le vrai futur des modèles de langage : des outils compacts, économiques et redoutables.
Mais la communauté rejette cette version. Sur Reddit, Substack ou LinkedIn, les critiques pleuvent. On traite presque Sonnet 5 de déchet inutile. Je refuse de croire ce discours excessif. Pourtant, je conteste aussi la communication d’Anthropic qui place d’office ce modèle au niveau d’un Opus 4.8.
Où se situe la vérité ? Sonnet 5 est-il performant ou décevant ? Est-il efficace pour des tâches précises ?
Je vous propose de disséquer cette mise à jour. Nous analyserons les modifications techniques, les graphiques promotionnels et la réalité des critiques des utilisateurs
- Sonnet 5 introduit trois changements mécaniques majeurs, dont un niveau d’effort inédit nommé
xhighet une réflexion active par défaut. - Un nouveau tokenizer augmente le nombre de jetons de 30 % à 40 % pour un même texte, ce qui réduit la fenêtre de contexte réelle disponible.
- Les gains de performance affichés par le constructeur reposent sur des comparaisons inégales entre différents niveaux d’effort.
- Les tests indépendants révèlent un coût par tâche doublé lors d’un usage intensif par rapport à la version précédente.
- La précision du modèle s’améliore pour la correction d’anomalies, générant moins de pollution visuelle dans les revues de code.
[CONFIG_SYS] L’évolution vers un comportement d’agent
La mise à jour de Sonnet 5 repose sur trois piliers techniques.
- Un niveau d’effort supérieur inédit.
- Un système de réflexion actif par défaut.
- Un tokenizer modifié.
Le paramètre d’effort : qu’est-ce que c’est ?
Ce curseur détermine le temps alloué au modèle pour analyser son travail avant de répondre. Un effort élevé consomme plus de jetons de raisonnement. Cela multiplie les appels d’outils et ralentit la réponse. Le coût augmente. À l’inverse, un effort minimal cherche une réponse immédiate.
Sonnet 4.6 proposait déjà les options low, medium, high et max. Sonnet 5 ajoute le niveau xhigh. Ce réglage se situe juste entre high et max. Il cible le codage à long terme et le travail autonome d’envergure. La documentation d’Anthropic confirme cette exclusivité.
Note de l’instructeur : Les modes Planification et Objectif priment sur le niveau d’effort pur. La rigueur avant la saisie de votre consigne reste la clé du succès.
La réflexion adaptative
Auparavant, l’absence du champ dédié désactivait la réflexion. Désormais, Sonnet 5 réfléchit de manière automatique. Vous devez spécifier thinking: {type: "disabled"} pour couper cette fonction. L’option de budget fixe disparaît. Le modèle gère lui-même son temps de réflexion. Cette perte de contrôle rebute certains utilisateurs. Pourtant, la gestion autonome de l’effort par la machine s’avère logique pour l’avenir des agents.
Le nouveau tokenizer
Sonnet 5 convertit le texte en un nombre supérieur de jetons. Anthropic annonce une hausse de 1,0 à 1,35 fois. Le spécialiste Simon Willison confirme ces chiffres lors de tests précis. Comptez 1,4 fois plus de jetons en anglais, 1,33 en espagnol et 1,28 pour du code Python.
À prix égal pour mille jetons, une requête coûte donc 40 % de plus. Ce changement réduit aussi la capacité d’accueil de la mémoire. La fenêtre affiche toujours un million de jetons. Mais un document qui occupait jadis une fraction de cet espace sature désormais le système plus vite. L’espace utile diminue.
[ANALYSE_DATA] Les mesures de performance d’Anthropic
L’éditeur présente Sonnet 5 comme son outil le plus apte à l’autonomie. Les résultats internes semblent impressionnants.
- Sur SWE-bench Pro, le taux de réussite passe de 58,1 % à 63,2 %.
- Terminal-Bench 2.1 grimpe de 67,0 % à 80,4 %.
- FrontierCode fait un bond de 15,1 % à 38,8 %.
- AutomationBench progresse de 5,3 % à 13,5 %.
Ces épreuves exigent de la persévérance et de l’auto-correction. Elles collent aux forces de ce modèle.
Une faille dans la comparaison
Une lecture attentive de l’annexe technique de l’éditeur révèle un biais. Pour Terminal-Bench 2.1, Anthropic oppose Sonnet 5 configuré en xhigh à Sonnet 4.6 en mode high. L’affrontement manque d’équité. Les gains affichés découlent en partie de cette asymétrie de configuration. Le constructeur omet aussi de préciser les réglages de Sonnet 4.6 pour les autres tests.
[COMPTABILITÉ] Le coût réel de l’intelligence
Sonnet 5 surpasse la mouture précédente si nous comparons les données de l’éditeur. Pour le niveau high, le taux de réussite atteint 80 % contre 75 % auparavant. Mieux encore, le coût par tâche s’effondre à 7 dollars contre 25 dollars pour l’ancienne version.
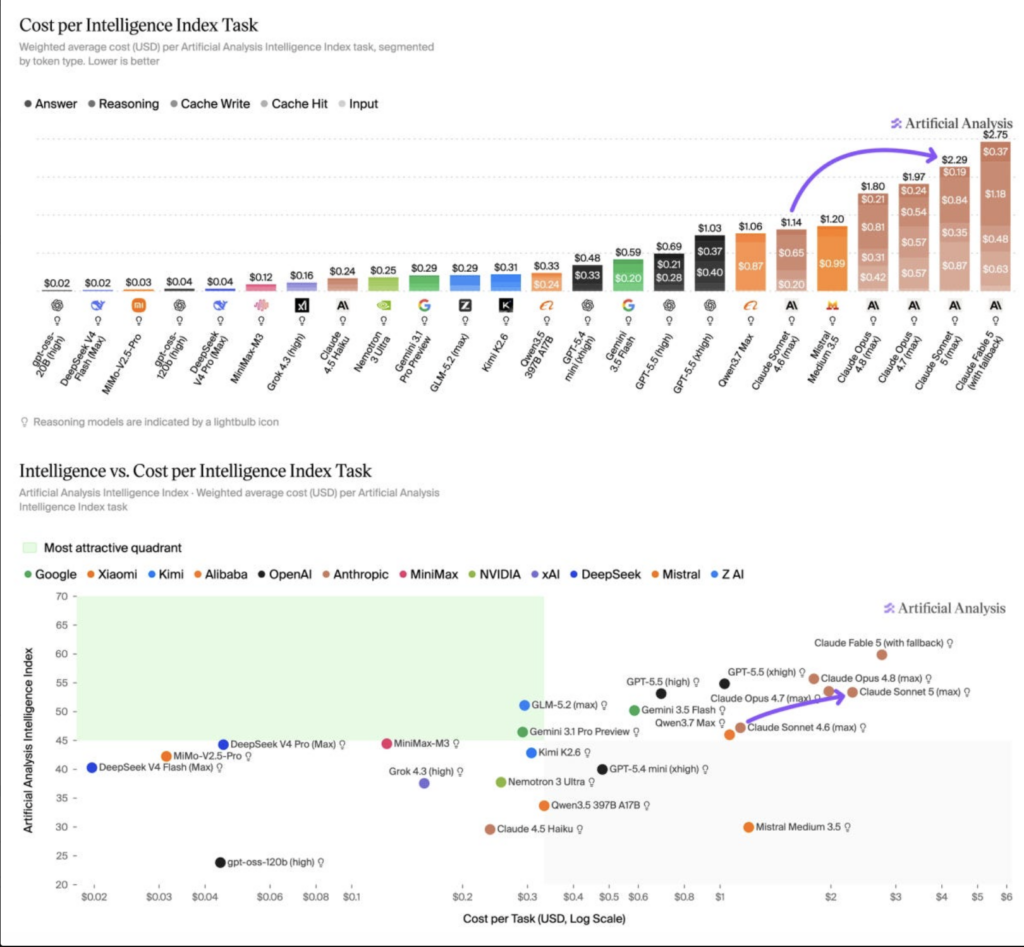
Les analyses de la structure indépendante Artificial Analysis dressent un bilan opposé. Selon leur indice, Sonnet 5 coûte 2,29 dollars par tâche, soit le double de la version 4.6.
Cette divergence s’explique par l’utilisation du niveau d’effort maximal. À ce stade, Sonnet 5 génère beaucoup plus de jetons et multiplie les cycles de travail. Les promesses d’économies d’Anthropic s’estompent à plein régime.
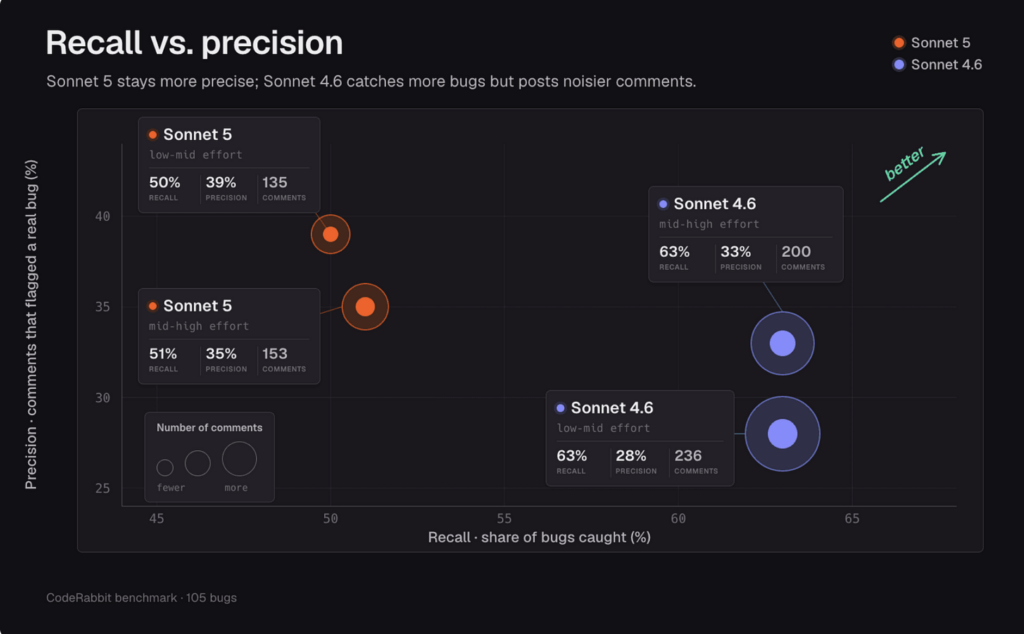
La précision compense ce coût. L’équipe de CodeRabbit constate une meilleure traque des anomalies. Sonnet 5 produit moins de faux positifs et de commentaires futiles lors de la relecture de code.
Si vous produisez du logiciel au quotidien, adoptez Sonnet 5. Utilisez le réglage d’effort medium pour préserver votre budget.
Face à Opus 4.8
Au niveau maximal, l’écart se resserre. Cependant, ce mode ruine rapidement votre budget. À bas niveau d’effort, Opus 4.8 maintient un rapport qualité-prix équivalent. Sonnet 5 se défend bien à effort moyen, mais sans miracle financier.
[CRITIQUE] Les points de rupture du modèle
Les bancs d’essai théoriques oublient parfois l’expérience vécue. La communauté exprime son mécontentement. Les critiques fusent sur les réseaux.
- Des refus de répondre plus fréquents sur des requêtes ordinaires à cause des nouveaux filtres de sécurité.
- Une sensation de lenteur générale lors de la génération.
- Un ton jugé condescendant ou moralisateur lors des échanges techniques.
- Un phénomène de baisse de valeur perçue au fil des versions.
Anthropic a commis une erreur stratégique en ciblant Opus 4.8 dans sa communication. Les utilisateurs s’attendaient à un saut technologique majeur et ont subi les défauts de jeunesse du système.
[ACTION] Faut-il croire les graphiques ou les réseaux ?
Ni l’un, ni l’autre. Un graphique vendeur montre des conditions optimales. Un message de colère sur le web reflète un cas isolé souvent mal configuré.
La solution consiste à bâtir votre propre protocole. Sélectionnez une vingtaine de tâches réelles issues de votre quotidien. Évaluez le comportement de Sonnet 5 sur ces exemples précis en mesurant le rapport entre coût et réussite. Si le niveau moyen remplit vos critères à moindre coût, la transition s’impose. Sinon, conservez vos outils actuels.
Références utiles
- Annonce officielle sur le Blog d’Anthropic pour comprendre leur vision initiale.
- Analyse détaillée du tokenizer par Simon Willison.
- Documentation technique d’Anthropic sur les niveaux d’effort.
- L’étude comparative des coûts sur Artificial Analysis.
- Le ressenti global partagé sur le billet de Katie Parrott.
- Discussions de la communauté sur Hacker News à propos du comportement du modèle.